 ぜり

「これは Google I/O か?」とばかりに、 Google との提携による AI 機能の拡充をアピールした Apple。「結局 Gemini 頼り、Googleの発表で見たようなのばかりじゃん!」「何年遅れの消しゴムマジックだよ!」と、失望の声も大きく聞かれました。
ただ忘れてはいけないのは、 WWDC はあくまで開発者向けのイベント だということ。基調講演の裏では様々な情報が公開されており、その中には「Apple にしかできない、唯一無二の AI 戦略」が含まれていました。
Apple のオンデバイス AI 「AFM 3 Core」
今回 Apple は、 Apple Intelligence 対応デバイス向けのオンデバイス AI モデル として AFM 3 Core を発表しました。
AFM 3 Core は、クラウドを介さず端末上で動作する 完全オンデバイス のエッジ AI モデル。入力したデータは全てデバイス上で処理されるため、通信環境がなくても利用できます。
構成は以下の 2 つ。 Advanced はパラメータ数が多く高性能な一方、 動作する機種が限られます。
- AFM 3 Core: Apple Intelligence 対応デバイス全てで動作。パラメータ数 3B。
- AFM 3 Core Advanced: より高性能な Apple Silicon 搭載デバイスで動作。パラメータ数 20B。
まず前提として、 Dense モデルは推論時にモデル全体の重みを使うため、モデルデータを丸ごとメモリに置いておく必要があります。 MoE モデルであれば計算に使うのは一部の Expert だけで済みますが、それでも標準的な設計では、どのトークンをどの Expert に渡すかを高速に判断するため、 全Expert の重みを DRAM に常駐させておくのが基本 です。
ところが AFM 3 Core Advanced は、 MoE モデルでありながら モデル全体を常時メモリにロードしません。 常駐させるのは、最低限の文脈理解を担う共有ネットワークと、 Expert のインデックス情報だけ。 プロンプト単位でルーティングされた Expert の領域のみをストレージから読み出し 、常駐部分と組み合わせて実行します。
これにより、省メモリでありながら MoE 特有の高速・高効率・高精度な推論を両立。 メモリ容量や帯域に強い制約のあるスマートフォンでも、オンデバイスとしては破格の 20B 級モデルを扱う道筋 を示しました。
なお、ローカル LLM の世界でも GGUF のように、巨大なモデルファイルを扱いやすくする形式・仕組みは広く使われています。ただし、これらはあくまで「モデルをどう保存し、どう読み込むか」の工夫。 AFM 3 Core Advanced が重要なのは、読み込み方にとどまらず、 モデル構造そのものを端末の制約に合わせて設計している点 です。
整理すると、標準的な MoE が「全体をメモリに読み込んだ上で、トークンごとに使う Expert を選ぶ」のに対し、 AFM 3 Core Advanced は 「まずプロンプト単位で使う Expert を決め、生成中も必要に応じて選び直し、動的にロードする」 構造です。 20B クラスのモデルデータをストレージに置いたまま、 推論時に有効化するパラメータ数も、メモリ使用量も、ストレージからメモリへの転送量も大きく抑えています。
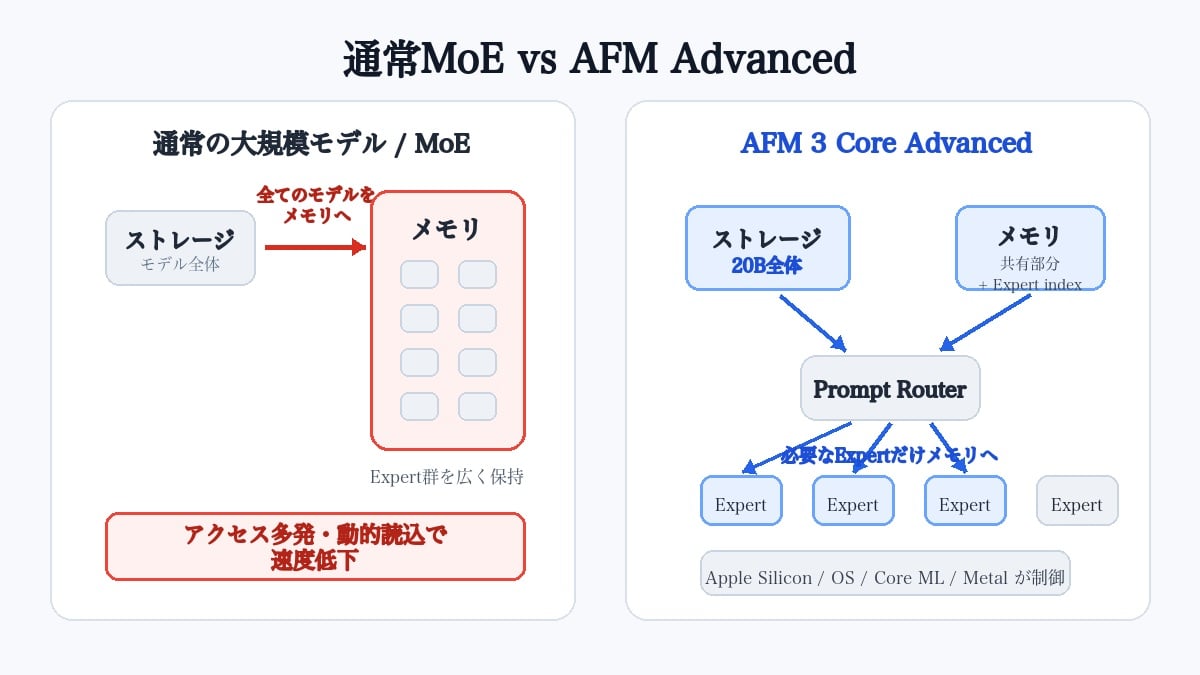
こうした構造は、モデル単体の工夫だけでは成立しません。ストレージ、メモリ、推論ランタイム、チップの特性まで、一体で設計する必要があります。 Apple は MLX のような Apple Silicon 向け ML 基盤に加え、 Core ML / Foundation Models framework / Metal / Neural Engine 、そして OS まで、全スタックを自社で抱えています。
だからこそ、モデルを「全部載せるか、載せないか」の二択ではなく、 その入力に必要な部分だけを、その端末のメモリ制約の中で組み立てて動かす という、推論専用ハードウェアに近い発想を製品レベルに落とし込めたのでしょう。 (もっとも、実際の性能はモデル次第。この構造がどれほど “強い” のかは、出てくるまでわかりませんが……)
着々と進む Apple の「AI 基盤」の整備
AFM 3 Core に限らず、 Apple はハードウェアの面でも「AI を実行しやすい環境」として先行しています。 Mac の M シリーズチップは、高速な LPDDR メモリと広大なバス幅で超高帯域を実現。さらに macOS は OS レベルで完全な UMA アーキテクチャを採用しており、 RAM から VRAM へのデータ転送そのものが存在しません。
一方の競合はというと、 NVIDIA はコンシューマ向けに大容量メモリの GPU を出さず、 AMD / Intel はソフトウェアの事情で性能が出にくい上、メモリ容量も十分とは言えません。結果として、オープンウェイトモデル (誰でもダウンロードできるモデル) をローカルで動かしたい場合、 最も手軽でコストパフォーマンスに優れる環境は Mac になりつつあります。
また Apple M5 シリーズでは、 GPU コアごとに Neural Accelerator を搭載するなど、 AI ワークロードを GPU 側でも高速に処理する方向へ進化しています。 MLX 自体が GPU も活用するスタックであり、正しい方向性と言えるでしょう。 M5 Pro / M5 Max のような大容量メモリ・高帯域の構成なら、モデルや量子化次第で、オープンウェイトモデルをローカルでも実用的な速度で動かせます。
米中の「AI 開発戦争」の恩恵もあり、オープンウェイトモデルにも、プログラミングや日常作業で十分実用になるものが続々と登場してきました。そんな中で Apple は、「誰でもモデルを使える環境」を着々と整備しています。
つまり「Apple は AI 時代に取り残されている」という言説は、ユーザー体験の面では今まさに正しい。しかし、実行・開発環境と将来へのロードマップという面では、実態は全く異なると捉えることができます。