 會原

Genie 4が生成した世界(AI生成画像)
文章から映像を作るAIは、Googleの「Veo」などでいくらか身近な存在になりつつあります。しかし、そうしたAIが作るのは、決まった長さの「見るだけ」の映像です。
一方、Google DeepMindが開発を続ける「世界モデル」は、なんとAIが作った世界の中を歩き回り、文章の指示でその場の出来事まで変えられるというもの。
同社は10月27日(米国時間)、その最新版の世界モデルとなる「Genie 4」を発表しました。
まだ限られたテスター向けの研究プレビューながら、Genie 4は映像と同時に環境音や音楽、登場人物との会話まで生成。人や物の動きもより写実的になり、同社は「これまでで最も写実的でインタラクティブな世界モデル」と謳います。
This is Genie 4, our most realistic and interactive world model yet. 🌐 Explore dynamic environments in real time to see how the scene responds, sounds, and how the people in it move, react, and speak. pic.x.com/6mmSUm9BBO
— Google DeepMind (@GoogleDeepMind) October 27, 2026
Genie 4では、移動とカメラの操作に一般的なキーボード操作を使い、文章で場面を動かします。例えば天気を変える、カメラを動かす、新しい人物や物を登場させるといった指示を、世界が動いている最中に入力可能。
そして、GoogleのAI「Gemini」が指示を周囲の場面に合うように解釈し、指示と指示の間も場面を見守って、世界が自然に進むよう導くとしています。
Google DeepMindが公開した例には、イラストの街並みを1枚の参照画像として渡し、同じ画風のまま通りを進んでいける世界に変えるものも。プロンプトでは、脇道へ曲がる動きや行き交う車と人、街のざわめきまで指定しています。
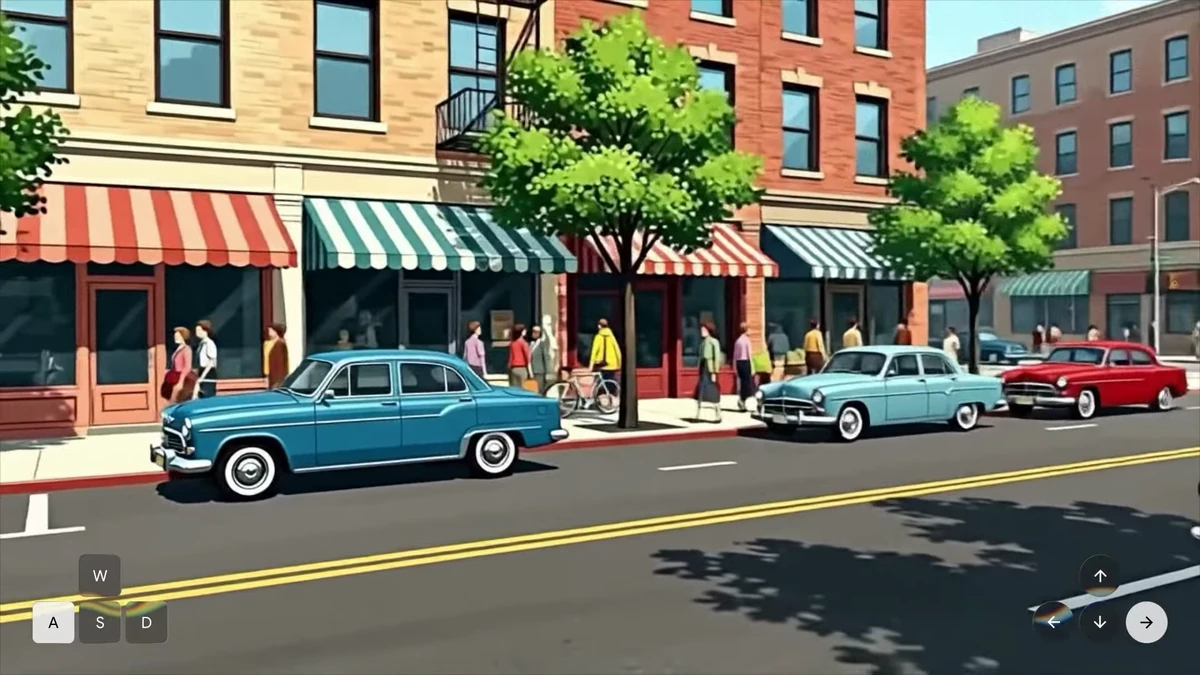
イラストの街並みを参照画像にした例(Google DeepMindのデモ映像より)
物理法則の再現も強化。同社によると、Genie 4は空気力学や衝突など現実の物理現象を再現し、物がぶつかり、水が流れ、木が風に揺れる環境を作れます。
加えて、Google DeepMindのリアルタイム世界モデルとしては初めて、音を映像と一緒に直接生成。足元で落ち葉が鳴る音や歓声、風や波の音といった環境音に加え、登場人物は利用者の入力や世界の出来事に反応して、その場で会話します。
現実の見た目や振る舞いはGeminiファミリーの「Gemini Omni」が支え、場面のつじつまや連続性を保つための推論はほかのGeminiモデルが担当。
さらに「Gemini 3.8 Flash」が案内役として常に場面を観察し、目標を手順に分解して、届いたフレームを見ながら各手順の成否を確認します。利用者が途中で介入しても計画を組み直し、因果関係のある複数手順の出来事を作れるといいます。つまり複数モデルのオーケストレーションで、リアルタイム世界生成を実現していると言えますね。
Excited to share Genie 4 today our most realistic and interactive world model: – steer dynamic environments in real time, shaping events, camera angles, and actions – generate native audio matched to the world, from realistic background sounds to characters who can converse in real time! – simulate photorealistic scenes and real-world physics – create more coherent multi-step events through reasoning from Gemini We’ve started to roll out as a research preview to trusted testers. Coming soon to Google AI Ultra subscribers in Project Genie and early access partners via the Gemini API and AI Studio.
— Sundar Pichai (@sundarpichai) October 27, 2026
同社はロボット研究への応用も試しています。公開した例では、「Gemini 4 Argon」がタスクを手順に分解してGenie 4へ文章で伝え、Apptronik製の人型ロボット「Apollo」がチェッカーで遊ぶ様子を描きました。
前世代のGenie 3は2025年8月に発表され、720p・毎秒24フレームの世界を生成し、数分間の一貫性を保てるとしていました。しかし、音は生成しませんでした。
一方、Genie 4の解像度やフレームレートは公表されておらず、公式の説明では、連続して操作できるのは長時間ではなく数分程度。時間がたつほど、複雑な指示を重ねるほど、また場面の中を動き回るほど、見た目の細部や物の存在が変わったり崩れたりすることがあるとのこと。米TechCrunch誌は、Genie 4が一貫した場面を保てるのは最大2分だと伝えています。
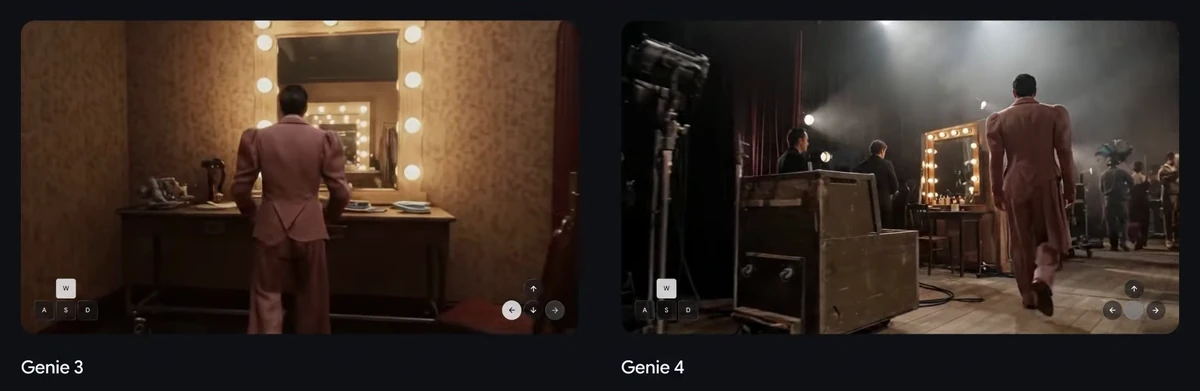
Genie 3(左)とGenie 4(右)の比較(AI生成画像。Google DeepMindのデモ映像より)
提供はまず信頼できるテスター向けの研究プレビューとして始まり、今後はGoogle AI Ultraの加入者向けの「Project Genie」や、Gemini APIとGoogle AI Studioの早期アクセスパートナーにも提供する予定です。
提供時期は「近日」。料金は現時点では不明。Project Genieでの利用については、順番待ちリストへの登録を受け付けています。Genie 4が生成する映像と音声には、すべて電子透かし「SynthID」を入れているそうです。
文章で「雨を降らせて」と打てば、その場で空模様が変わる世界を歩ける。映像生成AIの延長というより、ゲームエンジンを丸ごと言葉で動かしているような感覚で、これはワクワクします。ただ現時点では一貫性を保てる時間は短いため、ゲームの代わりにはならなさそうです。それより映画やゲームの企画の叩き台を想像するための道具として先に花開きそうな気がします。いつ、どの料金で降りてくるのか。試せる日が待ち遠しいところです。